


מהסתברות להחלטה: התפלגות בטא, עדכון בייסיאני ותועלת מצופה
הרבה פעמים אנחנו משתמשים בסטטיסטיקה על מנת לייצר מודל של אי ודאות לגבי הסתברויות. בין אם זה הסיכוי של מטבע לנחות על ראשו או שיעור ההצלחה של קמפיין שיווקי. התפלגות בטא, התחומה בין 0 ל-1, היא בחירה טבעית למשימות אלה. מדריך זה יציג את התפלגות בטא ואת תהליך העדכון הבייסיאני כמסגרת עבודה מעשית לבחינת הסתברויות, ילמד כיצד להפיק תחזיות על תוצאות עתידיות, ויסיים בקבלת החלטה כלכלית על בסיס תועלת מצופה והחזר על ההשקעה (ROI).
לאורך המדריך נעקוב אחר סוחר רהיטים שמעריך את שיעור ההמרה של אתר האינטרנט שלו, מעדכן את ההערכה לפי נתוני מכירות אמיתיים, חוזה כמה מבקרים יקנו בהמשך, ומחליט איזה קמפיין פרסום כדאי להפעיל. המדריך מלווה בקוד Python שאפשר להתאים למקרי השימוש של הקורא, כך שניתן ליישם את הרעיונות הלכה למעשה.
בקצרה (אמל"ק)
התהליך בשישה צעדים:
- מגדירים את ההסתברות המקדימה (פריור) באמצעות שיעור המרה משוער (p) ומשקל הפריור (N), כלומר כמה מבקרים "שווה" הפריור. למשל, "1 מכל 6, כמו נתונים של כ-100 מבקרים" נותן Beta(α, β) = Beta(16.67, 83.33).
- מעדכנים עם הנתונים שנאספו: מוסיפים את מספר הרוכשים ל-α ואת מספר מי שלא רכשו ל-β.
- מעמתים את הנתונים עם ההסתברות המקדימה (הפריור): אם הנתונים רחוקים מאוד ממה שהפריור צפה, עוצרים ובודקים מה השתבש לפני שמחליטים.
- מבצעים תחזית: בעזרת ההתפלגות הבטא-בינומית מחשבים כמה רוכשים צפויים מ-n המבקרים הבאים, ובאיזה טווח חיזוי (לרוב 95%). הטווח המתקבל בתהליך החיזוי רחב מהרווח בר-המהימנות, כי הוא כולל גם את הרנדומליות של התוצאה.
- מחשבים לכל עלות אפשרית: נקודת איזון, ROI מצופה, הסיכוי להפסד והסיכוי לעמוד בסף התשואה שקבענו.
- מחליטים, ובודקים יציבות: מפעילים רק קמפיין שה-ROI המצופה שלו עומד בסף ושסיכון ההפסד שלו נסבל. בוחנים את ההחלטה עם פריורים שונים כדי לראות אם היא יציבה.
המונחים בעברית ובאנגלית: רגע של עברית.
מברנולי לבינומי: קיצור תולדות ההתפלגות הבינומית
הסיפור מתחיל בהתפלגות ברנולי, המטפלת בניסוי יחיד עם שתי תוצאות אפשריות. לדוגמה, הטלה של מטבע. או שהמטבע נופל על "עץ" או שנופל על "פלי".
כאשר עושים מספר ניסויים עצמאיים של ברנולי, המספר הכולל של ההצלחות מתואר על ידי התפלגות בינומית. לדוגמה, הטלה של מספר מטבעות.
התפלגויות בסיסיות אלה משמשות לתיאור תהליכים בינארים, ומהוות בסיס להתפלגות בטא.
התפלגות בטא
התפלגות בטא נכנסת לתמונה כאשר מחלקים את מספר ההצלחות (והכישלונות) במספר הכולל של הניסויים דבר המעביר את המיקוד מספירת הצלחות לכימות אי הוודאות לגבי ההסתברות הבסיסית להצלחה אשר ערכה, כמו התפלגות בטא, תחום בין 0 ל-1. לדוגמה, ניסוי בהטלת מטבע כאשר "הצלחה" מוגדרת כקבלת "עץ". לאחר 10 הטלות, מתוכם 7 נפלו על "עץ" שיעור ההצלחה הוא 7/10=0.7 ושיעור הכישלון הוא המשלים ל-1, דהיינו 3/10=0.3.
התפלגות בטא מאופיינת בשני פרמטרים, α ו-β, שערכם נקבע על פי מספר ההצלחות והכישלונות. α הוא מספר ההצלחות ו-β הוא מספר הכישלונות:
$$ \operatorname{Beta}(\alpha, \beta) $$
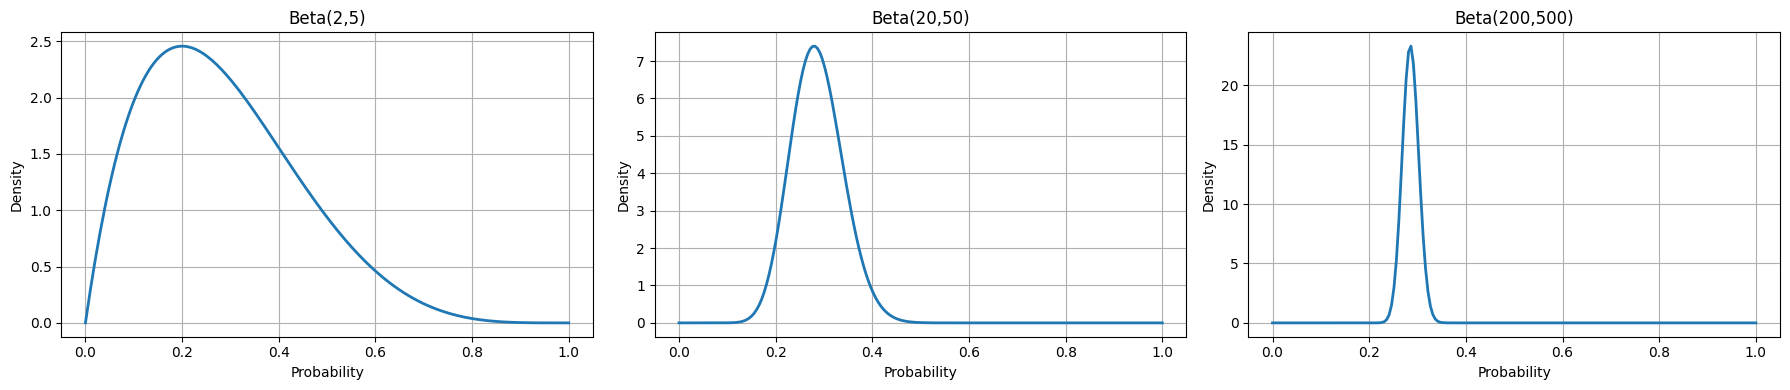
α ו-β קובעים את צורת ההתפלגות כפי שאפשר לראות בתרשים הבא:

בהמשך נראה שחלק מההצלחות והכישלונות האלה יכול להגיע מידע קודם (הפריור) ולא רק ממדידה. כשמתחילים בלי שום ידע מוקדם (פריור שטוח) מוסיפים 1 לכל פרמטר:
לפני הנתונים: Beta(1, 1)
אחרי הנתונים: Beta(successes + 1, failures + 1), כאשר successes הוא מספר ההצלחות ו-failures מספר הכישלונות.
-
פונקצית הצפיפות (PDF) של התפלגות בטא מחושבת באמצעות הנוסחה:
$$ f(x; \alpha, \beta) = \frac{x^{\alpha-1} (1-x)^{\beta-1}}{\int_0^1 t^{\alpha - 1} (1 - t)^{\beta - 1} dt} $$
כאשר:
- α ו-β קובעים את הצורה.
- x מוגדר בטווח שבין 0 ל-1.
- המכנה הוא פקטור מנרמל.
-
השכיח mode מחושב באמצעות הנוסחה:
$$ \text{Mode} = \frac{\alpha - 1}{\alpha + \beta - 2}, \quad \alpha, \beta > 1 $$
והוא נמצא בערך המקסימום של הפונקציה.
הממוצע מחושב באמצעות הנוסחה:
$$ \text{Mean} = \frac{\alpha}{\alpha + \beta} $$
והוא נוטה לעבר מרכז הכובד של הפונקציה. לדוגמה במקרה של 2,6 הוא יטה מעט ימינה מהשכיח בגלל שההתפלגות נוטה לימין.
סטיית התקן קטנה ככל שמספר הדוגמאות גדול יותר דבר המעיד על ביטחון רב יותר בהערכה.
ככל שמצליחים לאסוף יותר נתונים ההתפלגות מצטמצמת כיוון שסטיית התקן קטנה ככל שהתוצאה מבוססת על מספר רב יותר של דוגמאות:
בהתפלגות בטא משתמשים, בין השאר:
- להערכת הסתברויות ופרופורציות: לדוגמה, הערכת שיעור ההצלחה של ניסויים קליניים או הפרופורציה של הקלקות על מודעה באינטרנט.
- להערכת משך זמן ביצוע: בניהול פרויקטים משתמשים בהתפלגות כדי להעריך את משך הזמן הדרוש להשלמת משימות.
התפלגות בטא שימושית במסגרת של סטטיסטיקה בייסיאנית בגלל תכונות שנדגים בחלקו הבא של המדריך.
סטטיסטיקה בייסיאנית: מסגרת לעדכון הסתברויות בהינתן מידע חדש
מה שתהליך ההסקה הבייסיאני (Bayesian) עושה הוא לעדכן את ההערכות הקודמות שלנו בהינתן ראיות חדשות. את התהליך נתחיל מההסתברות המקדימה, הפריור (prior), המייצגת את אי הוודאות הראשונית שלנו לגבי ההסתברות. בעקבות איסוף נתונים במסגרת ניסוי או מחקר מעדכנים את המודל, אשר מפיק הסתברות מעודכנת, פוסטריור (posterior), המתחשבת בנתונים הראשוניים כמו גם בנתונים הנוספים.
העניין הוא שלא תמיד קל להפיק תוצאות שקל לעבוד איתן. יתרונה הגדול של התפלגות בטא כהתפלגות מקדימה (פריור) טמון בכך שגם ההתפלגות המעודכנת (הפוסטריור) שמפיק המודל היא בטא, מה שמקל על הפיתוח המתמטי ופירוש התוצאות. תכונה זו, שבה העדכון הבייסיאני מחזיר התפלגות מאותה משפחה שממנה התחלנו, קרויה צמידות (conjugacy), ובטא היא התפלגות צמודה (conjugate) לבינומית.
מה שתהליך ההסקה הבייסיאני (Bayesian) עושה הוא לעדכן את ההערכות הקודמות שלנו בהינתן ראיות חדשות.
למה התפלגות בטא מכונה "הסתברות של הסתברויות"?
כאשר אנו עוסקים בבעיות שבהן קיימת אי-וודאות לגבי ערך ההסתברות (למשל, ההסתברות שמטבע שאנחנו חושדים שהוא מוטה ינחת על "עץ") אנחנו לא יודעים לנקוב בערך הסתברות אחד ספציפי. לגבי מטבע כזה אי אפשר להגיד "ההסתברות היא 0.5" כי אנחנו לא באמת יודעים אבל מה שאנחנו כן יכולים לעשות הוא לתאר את הסיכויים באמצעות התפלגות. במקרה של משתנה בינארי, התפלגות בטא,שהודות לה נוכל לומר משהו דומה ל "יש לנו הסתברות מסוימת (למשל, 95%) שהערך המבוקש נמצא בטווח שבין 0.3 ל-0.7".
בפועל, במקום להצביע על ערך יחיד של הסתברות, לדוגמה 50%, מגדירים פונקצית הסתברות בה α ו-β מייצגים את הידוע לנו לגבי מספר ההצלחות α והכישלונות β. בכך, אנחנו למעשה יוצרים התפלגות על ערך ההסתברות. כלומר, אנחנו מתארים את ההסתברות באמצעות טווח x של הסתברויות. זהו הרעיון מאחורי הכינוי "הסתברות של הסתברויות".
כאשר אנו אוספים נתונים ומעדכנים את ההתפלגות בעזרת עדכון בייסיאני, אנחנו מצמצמים את חוסר הוודאות: עם נתונים מועטים, נקבל התפלגות רחבה. ככל שמצטברים נתונים, ההתפלגות מתרכזת, ומצביעה על ערך הסתברות מדויק יותר. כך, באמצעות התפלגות בטא, אנו לא רק מגדירים ערך נקודתי אלא גם מביעים את מידת אי הוודאות שלנו לגבי ערך ההסתברות.
באמצעות התפלגות בטא, אנו לא רק מגדירים ערך נקודתי אלא גם מביעים את מידת אי הוודאות שלנו לגבי ערך ההסתברות.
דוגמה לתהליך עדכון בייסיאני
נניח שאתה בעל חנות רהיטים המעוניין לדעת האם אתר האינטרנט המושקע שלך יצליח למכור.
האפשרויות הן שמשתמש הנכנס לאתר שלך ירכוש ("הצלחה") או שלא ירכוש ("כישלון"). בגלל שלניסוי שאתה עורך יתכנו אחת משתי תוצאות, זהו ניסוי בינומי, ולכן כדאי לך להשתמש בהתפלגות בטא לצורך עדכון מודל בייסיאני ממנו תלמד על סיכויי ההצלחה של האתר.
איך בוחרים את ההסתברות המקדימה (הפריור)?
סוחר הרהיטים שלנו אינו יודע את שיעור ההמרה המדויק של האתר שלו, אבל הוא גם לא מתחיל מאפס. יש לו ניסיון מקמפיינים קודמים, השוואה לחנויות אחרות או נתוני ענף. לכן במקום פריור "שטוח" שמניח שכל שיעור המרה סביר באותה מידה, נעדיף פריור שמבטא את הידע והניסיון שעמם הסוחר נכנס לקמפיין.
יצירת הפריור דורשת שני דברים:
- שיעור ההמרה המשוער (p): מה הסוחר מאמין שיקרה. בדוגמה שלנו, מבקר אחד מכל שישה ירכוש, כלומר 1/6 ≈ 16.67%.
- משקל הפריור (N): כמה מבקרים "שווה" הפריור. N = 100 פירושו שהסוחר סומך על הפריור שלו כמו על נתונים של 100 מבקרים. אם יגיעו 100 מבקרים חדשים, לנתונים החדשים יהיה משקל שווה לפריור.
לקבלת הפריור נכפול p ב-N:
$$\alpha = p \cdot N, \qquad \beta = (1 - p) \cdot N$$
לדוגמה:
α = p · N = (1/6) · 100 ≈ 16.67
β = (1 − p) · N = (5/6) · 100 ≈ 83.33

Beta(α, β) = Beta(16.67, 83.33)
בחרנו פריור מתון של 100. הוא נותן לסוחר נקודת פתיחה סבירה, אבל כמה מאות מבקרים כבר יזיזו אותו בצורה ניכרת.
כדי שהבחירה תהיה ניתנת להגנה, כדאי לרשום מאיפה הגיע השיעור (קמפיין קודם, ענף, אתר מתחרה) ולמה בחרנו דווקא את המשקל הזה. בהמשך המדריך נבדוק גם כמה ההחלטה תלויה בבחירה הזו.
עדכון המודל
עדכון ראשון: ביום הראשון נכנסו לאתר 100 מבקרים ו-15 מהם רכשו. את הנתונים מוסיפים לפרמטרים הקיימים. ההצלחות ל-α והכישלונות (85) ל-β:
Beta(α, β) = Beta(16.67+15, 83.33+85) = Beta(31.67, 168.33)
עדכון שני: ביום השני נכנסו 200 מבקרים ו-38 מהם רכשו (162 לא רכשו). מוסיפים לתוצאה של השלב הקודם:
Beta(α, β) = Beta(31.67+38, 168.33+162) = Beta(69.67, 330.33)
שים לב שבכל שלב מוסיפים את הנתונים החדשים להתפלגות הקודמת, ולא לפריור המקורי. ההתפלגות בכל שלב כבר מכילה את כל מה שקדם לה: הפריור וכל הנתונים שנאספו עד כה. אפשר לראות זאת בסכום α+β, שמבטא את כמות המידע שהצטבר: 100 (הפריור), 200 (אחרי יום 1) ו-400 (אחרי יום 2, כלומר הפריור בתוספת 300 מבקרים). במילים אחרות, ההסתברות המעודכנת של יום אחד היא ההסתברות המקדימה של היום שאחריו.
קוד פייתון ליישום תהליך העדכון הבייסיאני
קלאס הפייתון BayesianUpdater להלן מחשב את המודל הבייסיאני אשר יסייע לסוחר להעריך כמה אתר האינטרנט שלו עשוי להצליח במכירות:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import beta

class BayesianUpdater:
    """
    A class to perform Bayesian updates on a Beta-Binomial model and visualize the process.
    The Beta distribution is the prior for the probability of success.
    """
    def __init__(self, alpha=1, beta_param=1):
        self.alpha = alpha
        self.beta = beta_param
        # Store the history of (alpha, beta) pairs, starting with the prior
        ci = self.credible_interval(self.alpha, self.beta)
        self.history = [(self.alpha, self.beta, ci)]

    def update(self, successes, failures):
        """Updates the distribution with new data and records the new state."""
        self.alpha += successes
        self.beta += failures
        ci = self.credible_interval(self.alpha, self.beta)
        self.history.append((self.alpha, self.beta, ci))

    def mean(self):
        """Calculates the current posterior mean."""
        return self.alpha / (self.alpha + self.beta)

    def mode(self):
        """Calculates the current posterior mode."""
        if self.alpha > 1 and self.beta > 1:
            return (self.alpha - 1) / (self.alpha + self.beta - 2)
        return "Not defined"

    def std(self):
        """Calculates the current posterior standard deviation."""
        num = self.alpha * self.beta
        denom = (self.alpha + self.beta)**2 * (self.alpha + self.beta + 1)
        return np.sqrt(num / denom)

    def credible_interval(self, a, b, conf=0.95):
        """
        Calculates the credible interval for a given alpha and beta.
        """
        lower = beta.ppf((1 - conf) / 2, a, b)
        upper = beta.ppf(1 - (1 - conf) / 2, a, b)
        return lower, upper

    def plot_updates(self, labels=None, conf=0.95):
        """
        Plots the prior and all posterior distributions on a single graph,
        highlighting the credible interval.
        """
        x = np.linspace(0, 1, 400)

        cmap = plt.get_cmap('viridis')
        colors = cmap(np.linspace(0.2, 0.8, len(self.history)))

        for i, (a, b, (lower, upper)) in enumerate(self.history):

            dist_pdf = beta.pdf(x, a, b)

            # Determine the label for the legend
            if labels and len(labels) == len(self.history):
                label_prefix = labels[i]
            else:
                label_prefix = "Prior" if i == 0 else f"Update {i}"

            label = f'{label_prefix}: {conf*100:.0f}% CI [{lower:.3f}, {upper:.3f}]'

            # Plot the main distribution curve
            plt.plot(x, dist_pdf, lw=2.5, color=colors[i], label=label)

            # Shade the credible interval area
            plt.fill_between(x, dist_pdf, where=(x >= lower) & (x <= upper),
                             color=colors[i], alpha=0.25)

        plt.xlabel('Probability Parameter (e.g., Conversion Rate)')
        plt.ylabel('Density')
        plt.title('Evolution of Beliefs with Bayesian Updating')
        plt.legend(title=f"Distribution & {conf*100:.0f}% Credible Interval")
        plt.grid(True, linestyle=':', alpha=0.6)
        plt.show()
הקוד הבא ישמש להרצת הקלאס לעיל:
# 0. Define the Prior

# The merchant believes that about 1 in 6 visitors will buy (p = 1/6),
# and trusts this belief as much as he would trust the data of 100 visitors (N = 100).
# alpha = p * N = 16.67, beta = (1 - p) * N = 83.33
alpha0, beta0 = 16.67, 83.33

updater = BayesianUpdater(alpha=alpha0, beta_param=beta0)

print(f"Prior: Beta({updater.alpha:.2f}, {updater.beta:.2f})")
print(f" Mean = {updater.mean():.3f}")
print(f" Mode = {updater.mode():.3f}")
print(f" Std. Deviation = {updater.std():.3f}")
lower, upper = updater.credible_interval(updater.alpha, updater.beta)
print(f" 95% Credible Interval = [{lower:.3f}, {upper:.3f}]\n")


# 1. First Update: 100 visitors, 15 bought

updater.update(15, 85)

print(f"1st Stage: Beta({updater.alpha:.2f}, {updater.beta:.2f})")
print(f" Mean = {updater.mean():.3f}")
print(f" Mode = {updater.mode():.3f}")
print(f" Std. Deviation = {updater.std():.3f}")
lower, upper = updater.credible_interval(updater.alpha, updater.beta)
print(f" 95% Credible Interval = [{lower:.3f}, {upper:.3f}]\n")


# 2. Second Update: 200 visitors, 38 bought

updater.update(38, 162)

print(f"2nd Stage: Beta({updater.alpha:.2f}, {updater.beta:.2f})")
print(f" Mean = {updater.mean():.3f}")
print(f" Mode = {updater.mode():.3f}")
print(f" Std. Deviation = {updater.std():.3f}")
lower, upper = updater.credible_interval(updater.alpha, updater.beta)
print(f" 95% Credible Interval = [{lower:.3f}, {upper:.3f}]\n")


# Generate the plot with custom labels
stage_labels = ["Prior Belief", "Day 1", "Day 2"]
updater.plot_updates(labels=stage_labels)
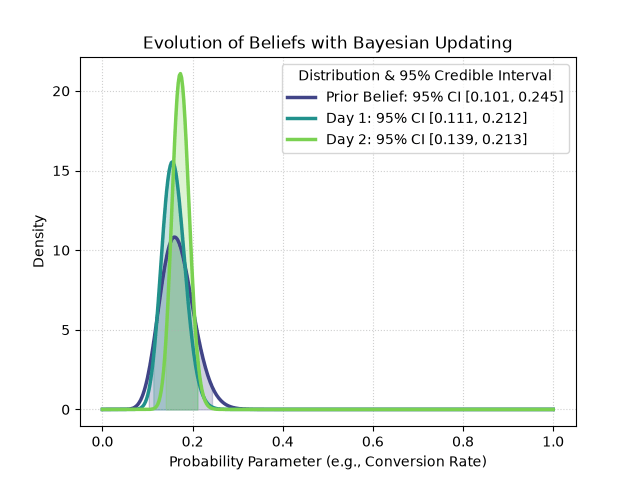
התרשים הבא מסכם את התוצאות:
Prior: Beta(16.67, 83.33)
 Mean = 0.167
 Mode = 0.160
 Std. Deviation = 0.037
 95% Credible Interval = [0.101, 0.245]

1st Stage: Beta(31.67, 168.33)
 Mean = 0.158
 Mode = 0.155
 Std. Deviation = 0.026
 95% Credible Interval = [0.111, 0.212]

2nd Stage: Beta(69.67, 330.33)
 Mean = 0.174
 Mode = 0.173
 Std. Deviation = 0.019
 95% Credible Interval = [0.139, 0.213]
ננתח את הממצאים
ככל שנאסוף יותר נתונים, ההתפלגות המעודכנת תתרכז יותר סביב הערך האמיתי. כלומר, הרווח בר-המהימנות (Credible Interval) קטן וסטיית התקן יורדת, מה שאומר שאנו יכולים להיות בטוחים יותר בתוצאות הודות לצמצום חוסר הוודאות.
התכנסות וצמצום חוסר הוודאות
- בשלב הראשוני (Beta(16.67, 83.33)):
הפריור של הסוחר מבוסס אך רחב למדי. סטיית התקן 0.037 והרווח בר-המהימנות בין 0.101 ל-0.245. הוא מאמין שהשיעור סביב 1 מ-6, אבל לא מוכן להתחייב על ערך מדויק. - עדכון ראשון (Beta(31.67, 168.33)):
לאחר 100 מבקרים ו-15 רכישות, הרווח הצטמצם ל-[0.111, 0.212] וסטיית התקן ירדה ל-0.026. - עדכון שני (Beta(69.67, 330.33)):
תוספת של 200 מבקרים ו-38 רכישות (בסך הכול 53 רכישות מתוך 300 מבקרים) הורידה את סטיית התקן ל-0.019 והרווח הצטמצם ל-[0.139, 0.213]. רוחב הרווח כמעט התקצר בחצי. מ-14.4 נקודות אחוז בפריור ל-7.4 נקודות אחוז.
פירוש הרווח בר-המהימנות (Credible Interval)
- לפי העדכון השני, ישנה הסתברות של 95% שההסתברות האמיתית לכך שמבקר יבצע רכישה נמצאת בין 0.139 ל-0.213.
- ההסתברות ששיעור ההמרה האמיתי נמצא מחוץ לטווח זה (על סמך הידע הנוכחי שלנו) היא 5% בלבד.
שינוי בהערכות נקודתיות (ממוצע ושכיח)
- בהתחלה: הממוצע 0.167 והשכיח (Mode) 0.160.
- עדכון ראשון: שיעור ההמרה ביום הראשון (15%) היה נמוך מהממוצע של הפריור (16.7%), ולכן הממוצע ירד מעט ל-0.158.
- עדכון שני: שיעור ההמרה ביום השני (19%) היה גבוה מהממוצע עד אז (15.8%), והממוצע עלה ל-0.174 (שכיח 0.173).
עדכון הוא לא תהליך שרק מוריד או רק מעלה, הוא עוקב אחר הנתונים.
אפשר להבין את הממוצע הסופי כממוצע משוקלל של הפריור עם הנתונים. משקל הפריור הוא 100 מבקרים עם שיעור של 0.167, ומשקל הנתונים שנאספו בשטח הוא 300 מבקרים עם שיעור של 0.177 (53/300). התוצאה:
$$\text{posterior mean} = \frac{N \cdot p_0 + n \cdot \hat{p}}{N + n} = \frac{16.67 + 53}{100 + 300} \approx 0.174$$
התוצאה קרובה יותר לנתונים, כי יש בהם יותר מידע מאשר בפריור. הפריור של הסוחר אושר, ולא תוקן, והאי-ודאות לגבי שיעור ההמרה קטנה בחצי.
האם הנתונים מתיישבים עם הפריור?
הפריור הוא לא רק מספר. הוא גם חיזוי. כשהסוחר אומר "אני מאמין שמבקר אחד מכל שישה יקנה", הוא אומר בעצם: "מתוך 100 מבקרים אצפה לכ-17 רוכשים, פלוס מינוס". לפני שמערבבים את הפריור הזה עם הנתונים, כדאי לשאול שאלה פשוטה: האם מה שקרה בפועל דומה למה שהפריור חזה?
אפשר להבין את זה מדוגמה עם מטבע. מישהו מאמין שמטבע הוגן, מטיל אותו 100 פעמים ומקבל 90 פעמים "עץ". אף אחד לא יטען "הפריור והנתונים קרובים מספיק, נערבב ביניהם". יותר סביר שהמטבע אינו מאוזן, או שמשהו אחר קרה. הבדיקה כאן עושה בדיוק את זה, רק עם מספרים.
מה הפריור חוזה?
נשאל את הפריור מה הוא מצפה לראות בכל אחת מקבוצות הנתונים שאספנו. כלי החיזוי הוא ההתפלגות הבטא-בינומית, שנסביר לעומק בחלק על החיזוי. כרגע אפשר להתייחס אליו כאל קופסה. נותנים לה פריור ומספר מבקרים, והיא מחזירה כמה רוכשים צפויים, ובאיזה טווח הם עשויים להיות.
| קבוצת נתונים | מבקרים | רוכשים צפויים לפי הפריור | הטווח הרגיל לפי הפריור (95%) | רוכשים בפועל |
|---|---|---|---|---|
| יום 1 | 100 | 16.7 | 7 עד 28 | 15 |
| יום 2 | 200 | 33.3 | 17 עד 53 | 38 |
| שני הימים | 300 | 50.0 | 27 עד 77 | 53 |
הנתונים בטבלה לקוחים מקוד שנציג בהמשך.
בשלוש השורות מה שקרה בפועל נמצא בתוך הטווח הרגיל, וקרוב למספר הצפוי. כלומר הנתונים דומים למה שהפריור חזה.
מספר אחד שמסכם: הסיכוי לזנב
אפשר לסכם את ההשוואה במספר אחד. נניח שהפריור נכון, ונחזור על הניסוי פעמים רבות (למשל 100 מבקרים). בכמה אחוזים מהפעמים נקבל תוצאה רחוקה באותה מידה או יותר, בכיוון שבו הנתונים סטו? המספר המתקבל הוא "הסיכוי לזנב" (tail probability):
- יום 1: קיבלנו 15, מעט פחות מהצפוי (16.7). ב-43.6% מהפעמים היינו מקבלים 15 או פחות.
- יום 2: קיבלנו 38, מעט יותר מהצפוי (33.3). ב-30.7% מהפעמים היינו מקבלים 38 או יותר.
ערכים כאלה, בין 30% ל-44%, אומרים שהתוצאה רגילה לגמרי. הנתונים בדיוק מהסוג שהסוחר ציפה לו.
איך נראית אי עמידה בציפיות?
נניח שביום הראשון היו 40 רוכשים מתוך 100, ולא 15. הפריור ציפה ל-17 בערך, בטווח רגיל של 7 עד 28, ולכן 40 רחוק הרבה מעבר לטווח. הסיכוי לזנב הוא כ-0.01%: פעם אחת בערך מכל 8,600 ניסויים. במקרה כזה אי אפשר לומר "נעדכן את הפריור ונמשיך", צריך להבין מה קרה.
כלל אצבע: אם הסיכוי לזנב נמוך מכ-1%, הנתונים והפריור לא מתיישבים. עוצרים לפני שמחליטים, ובודקים:
- האם הפריור היה לא מציאותי (למשל, הוא התבסס על עסק אחר או על נתונים ישנים)?
- האם משהו השתנה בנתונים החדשים: מקור התנועה, קמפיין, עונה?
- האם יש טעות בנתונים עצמם?
זו בדיקה גסה, לא מבחן סטטיסטי מלא. אף על פי כן, נתונים שסוטים בהרבה מהצפי צריכים להדליק נורה אדומה.
הקוד
הקוד הבא מחשב את הטבלה ואת הסיכוי לזנב:
from scipy.stats import betabinom

# Compare what the prior predicted with what we actually observed
for label, n, buyers in [("Day 1", 100, 15), ("Day 2", 200, 38), ("Both days", 300, 53)]:
    prediction = betabinom(n, alpha0, beta0)                   # the prior's prediction for n visitors
    low, high = prediction.ppf(0.025), prediction.ppf(0.975)   # the range it considers typical (95%)
    tail = min(prediction.cdf(buyers), 1 - prediction.cdf(buyers - 1))   # how often a result at least this far from expected
    print(f"{label}: observed {buyers}, prior expected {prediction.mean():.1f} "
          f"(typical range {low:.0f} to {high:.0f}), tail probability {tail:.1%}")
Day 1: observed 15, prior expected 16.7 (typical range 7 to 28), tail probability 43.6% Day 2: observed 38, prior expected 33.3 (typical range 17 to 53), tail probability 30.7% Both days: observed 53, prior expected 50.0 (typical range 27 to 77), tail probability 40.1%
השלכות עסקיות
- אם נשתמש בנתונים אלו לחיזוי ביצועים עתידיים, ייתכן שנבחר להשתמש בממוצע (0.174) כהערכה נקודתית. החלטה קונבנציונאלית שמתעלמת מהרבה מידע שאספנו בעמל בדרך.
- הגבול העליון (0.213) מציג תרחיש מיטבי, אך הסתמכות עליו בלבד עלולה להוביל להערכת יתר ולנטילת סיכונים מיותרים.
- כאשר מדובר בקבלת החלטות הדורשות זהירות (למשל, קביעת תקציבים לפרסום או הגדרת ציפיות הכנסה), אפשר להשתמש בגבול התחתון (0.139) כהערכה שמרנית. זהו כלל אצבע גס בלבד! הוא מתעלם מרוב המידע שבהתפלגות, ובהמשך המדריך נראה שהוא עלול אפילו להוביל להחלטה שגויה.
עדכונים עתידיים
- ככל שנמשיך לאסוף נתונים, צפוי שסטיית התקן והרווח בר-המהימנות יצטמצמו עוד יותר, מה שיביא להערכות מדויקות בהרבה.
- שינוי בתנאי השוק (למשל, קמפיין שיווקי חדש) עשוי להשפיע על התנהגות הצרכנים ולשנות את צורת ההתפלגות המעודכנת. במצב כזה כדאי לבדוק מחדש שהנתונים החדשים עדיין מתיישבים עם ההתפלגות הנוכחית.
מסקנות ביניים
הלקח המרכזי הוא שככל שאנו אוספים יותר נתונים, חוסר הוודאות קטן וההערכות שלנו נעשות מדויקות יותר. מעבר לכך, חובה לזכור שהדיווח הבייסיאני צריך לכלול לא רק הערכות נקודתיות (כמו ממוצע או שכיח), אלא גם טווחים של חוסר ודאות (דוגמת רווח בר-מהימנות ברמה של 95%), מה שמעניק תמונה מלאה של ה"סיכון" והביטחון בהערכות.
הדיווח הבייסיאני צריך לכלול לא רק הערכות נקודתיות, אלא גם טווחים של חוסר ודאות
רגע! עוד לא סיימנו
עד כה עזרנו לסוחר להבין כמה הוא מכר ביומיים הראשונים והאם זה עומד בציפיות שלו. אבל הסוחר שואל שאלה אחרת. לא "מהו שיעור ההמרה?", אלא "כמה מבקרים יקנו מחר, והאם כדאי לי להשקיע בקמפיין?". כדי לענות על כך נעבור מהערכה לחיזוי, ומשם להחלטה.
רווח בר-מהימנות וטווח חיזוי: כמה רוכשים נקבל בהמשך?
עד כאן ענינו על השאלה "מהו שיעור ההמרה האמיתי?". השאלה שמעסיקה את הסוחר היא בדרך כלל מעשית יותר: "אם מחר ייכנסו לאתר עוד 100 מבקרים, כמה מהם יקנו?"
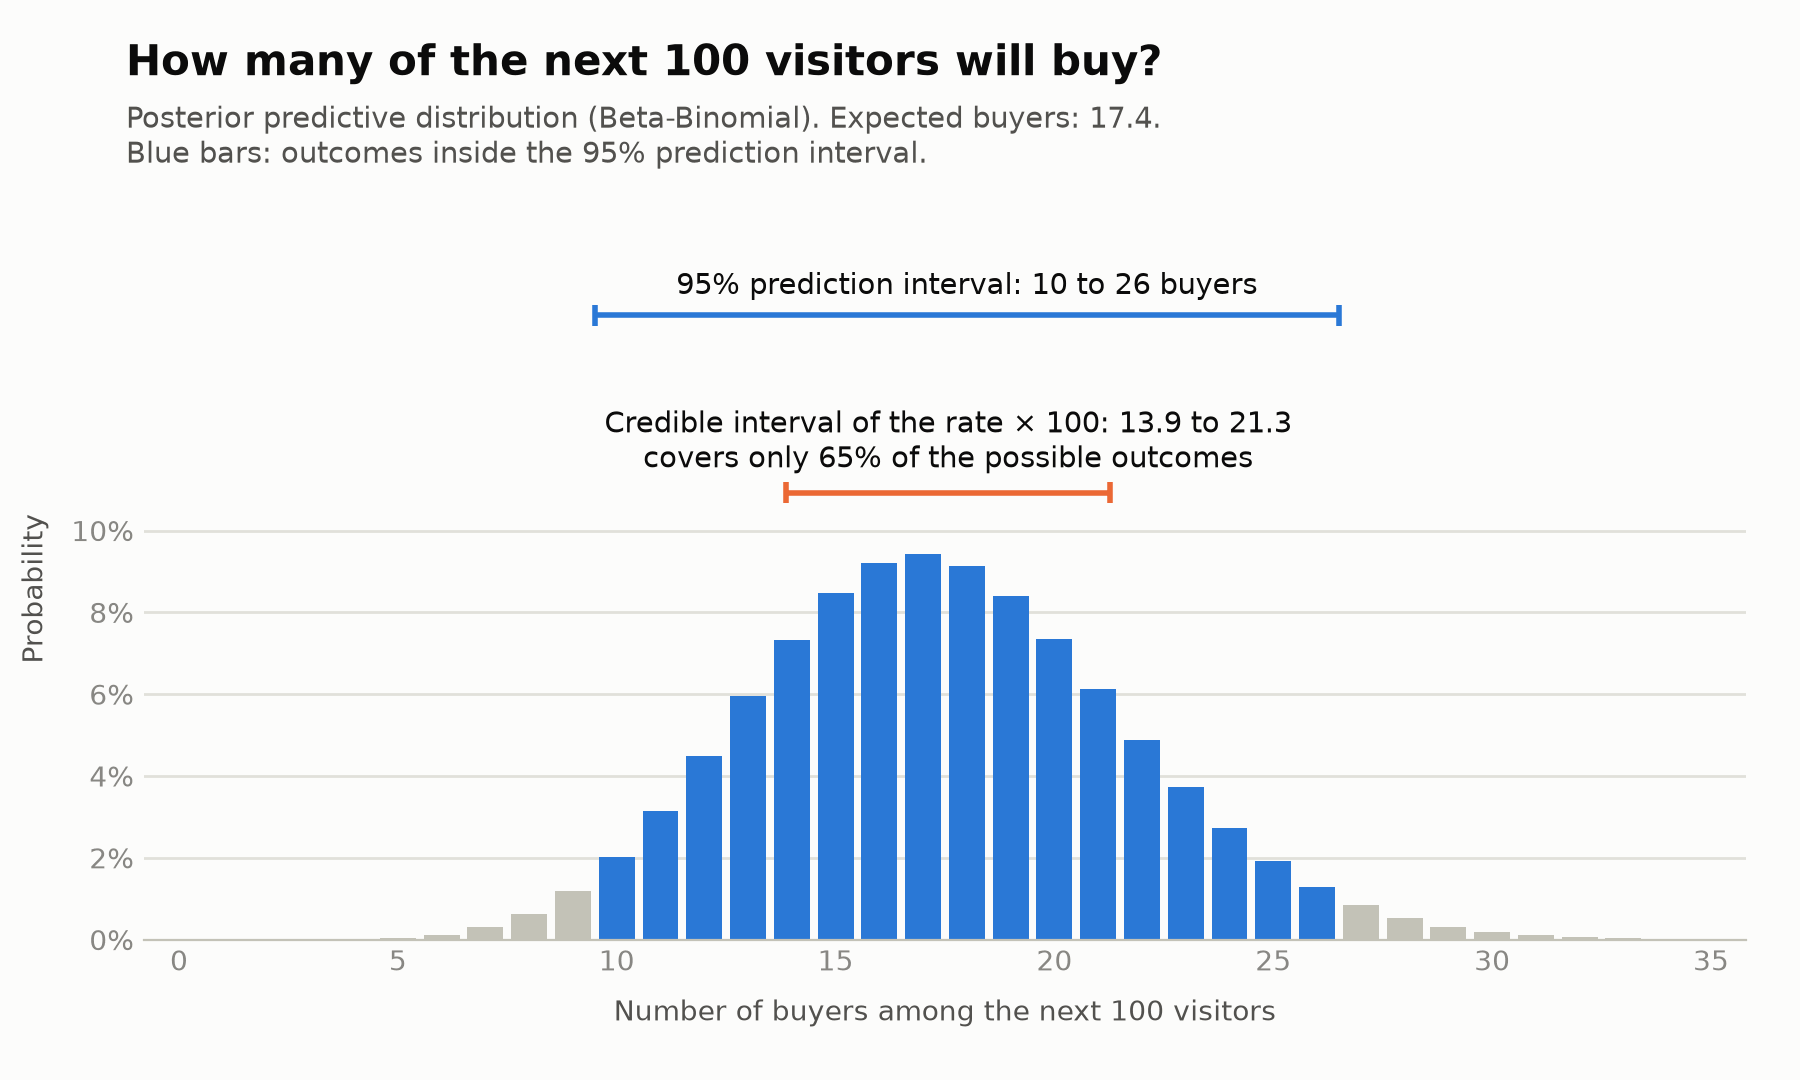
מפתה לקחת את הרווח בר-המהימנות [0.139, 0.213] ולהכפיל ב-100, כלומר לצפות לבין 14 ל-21 רוכשים. זו טעות, והיא יקרה. בפועל, בכ-35% מהימים מספר הרוכשים ימצא מחוץ לטווח הזה. הטעות נובעת ממקור שני של אי ודאות שהחישוב מתעלם ממנו.
שני מקורות של אי ודאות
- אי ודאות לגבי θ (שיעור ההמרה האמיתי). זה מה שההתפלגות המעודכנת Beta(69.67, 330.33) מתארת.
- הרנדומליות של התוצאה עצמה. גם אם היינו יודעים את θ בדיוק, נניח 0.174, מתוך 100 מבקרים לא נקבל בהכרח בדיוק 17 רוכשים. המספר משתנה מיום ליום לפי התפלגות בינומית.
הרווח בר-המהימנות מתאר רק את המקור הראשון. ההתפלגות המנבאת (posterior predictive distribution) מתארת את שניהם. כאשר ההתפלגות המעודכנת היא בטא והתוצאה בינומית, יש לה נוסחה סגורה שנקראת ההתפלגות הבטא-בינומית (Beta-Binomial).
שיטה ראשונה: סימולציה (עובדת לכל מודל)
- דוגמים ערך של הפרמטר, θ, מההתפלגות המעודכנת.
- בהינתן θ זה, דוגמים את מספר הרוכשים מהתפלגות Binomial(100, θ).
- חוזרים על שני הצעדים פעמים רבות. ההתפלגות של התוצאות היא החיזוי.
שיטה שנייה: ההתפלגות הבטא-בינומית המדויקת
במקרה שלנו, לא צריך לסמוך על סימולציה כיוון שספריית SciPy מחשבת את ההתפלגות הבטא-בינומית ישירות באמצעות betabinom.
הקוד הבא מדגים את שתי השיטות בפעולה:
import numpy as np
from scipy.stats import beta, betabinom

n_visitors = 100
a, b = updater.alpha, updater.beta   # Beta(69.67, 330.33) from the previous section

# --- Method 1: Monte Carlo ---
rng = np.random.default_rng(42)
theta_samples = rng.beta(a, b, size=100_000)         # 1. draw a rate from the posterior
k_samples = rng.binomial(n_visitors, theta_samples)  # 2. draw the number of buyers given that rate

print(f"Monte Carlo, next {n_visitors} visitors:")
print(f"  Mean:   {k_samples.mean():.1f}")
print(f"  95% PI: [{np.percentile(k_samples, 2.5):.0f}, "
      f"{np.percentile(k_samples, 97.5):.0f}]")

# --- Method 2: Exact Beta-Binomial ---
dist = betabinom(n_visitors, a, b)

print(f"\nExact Beta-Binomial, next {n_visitors} visitors:")
print(f"  Mean:   {dist.mean():.1f}")
print(f"  95% PI: [{dist.ppf(0.025):.0f}, {dist.ppf(0.975):.0f}]")

# --- Compare with the credible interval for theta, scaled by n ---
lo, hi = beta.ppf([0.025, 0.975], a, b) * n_visitors
print(f"\nCredible interval for theta, scaled by n: [{lo:.1f}, {hi:.1f}]")
הפלט:
Monte Carlo, next 100 visitors:
  Mean:   17.4
  95% PI: [10, 26]

Exact Beta-Binomial, next 100 visitors:
  Mean:   17.4
  95% PI: [10, 26]

Credible interval for theta, scaled by n: [13.9, 21.3]
שתי השיטות מסכימות עד כדי רעש הסימולציה. כ-17 רוכשים צפויים, וטווח החיזוי (prediction interval) של 95% הוא בין 10 ל-26.
למה טווח החיזוי רחב כל כך?
השונות של מספר הרוכשים החזוי היא (בקירוב) סכום של שני המקורות:
$$\operatorname{Var}(K) \;\approx\; \underbrace{n^{2}\,\sigma_{\theta}^{2}}_{\text{uncertainty about the rate}} \;+\; \underbrace{n\,\bar{\theta}\,(1-\bar{\theta})}_{\text{binomial noise}}$$
כאשר K הוא מספר הרוכשים, n מספר המבקרים העתידיים, σθ סטיית התקן של ההתפלגות המעודכנת, ו-θ̄ הממוצע שלה. הסימן ≈ נובע מכך שהנוסחה הזו מספקת קירוב טוב, לא הזהות המדויקת.
בדוגמה שלנו (n = 100, σθ = 0.019, θ̄ = 0.174):
- אי ודאות לגבי θ: 100² × 0.019² ≈ 3.6
- רעש בינומי: 100 × 0.174 × 0.826 ≈ 14.4
- סך הכול כ-18, כלומר סטיית תקן של כ-4.2 רוכשים, לעומת 1.9 ברווח בר-המהימנות לבדו.
$$\operatorname{Var}(K) \approx 100^{2} \cdot 0.019^{2} + 100 \cdot 0.174 \cdot 0.826 \approx 3.6 + 14.4 \approx 18$$
בדוגמה שלנו כ-80% מהשונות מגיעה מהרעש הבינומי.
זה לקח חשוב: איסוף עוד נתונים מצמצם את אי הוודאות לגבי θ, אבל לא את הרנדומליות של 100 המבקרים הבאים. גם אם נדע את שיעור ההמרה במדויק, מספר הרוכשים ביום מסוים ימשיך להשתנות.
מה שכן משתנה הוא היחס בין השניים כאשר מסתכלים על יותר מבקרים. בסקאלה של שיעור (K/n), טווח החיזוי מתקרב לרווח בר-המהימנות ככל שמספר המבקרים העתידיים גדל:
| מספר מבקרים עתידיים | טווח חיזוי של 95% (כאחוז מהמבקרים) |
|---|---|
| 100 | [10.0%, 26.0%] |
| 1,000 | [13.2%, 22.0%] |
| 10,000 | [13.8%, 21.4%] |
| הרווח בר-המהימנות של θ | [13.9%, 21.3%] |
התרשים הבא מראה כמה מתוך 100 המבקרים הבאים ירכשו, לפי ההתפלגות המנבאת (בטא-בינומית). העמודות הכחולות הן הטווח שבו מרוכזים 95% מהתוצאות האפשריות, בין 10 ל-26 רוכשים.
הקוד לקידוד התרשים נמצא בתחתית המדריך. ראה plot_prediction().
סיכום הפרק: רווח בר-מהימנות וטווח חיזוי
השלכות עסקיות, בחינה מחדש
קודם הצענו להשתמש בגבול התחתון של הרווח בר-המהימנות (0.139) כהערכה שמרנית. כשמתכננים מראש טווח החיזוי הוא הכלי המדויק יותר, כי הוא אומר מה אנחנו עשויים לראות בפועל.
כשמתכננים מראש טווח החיזוי הוא הכלי המדויק יותר, כי הוא אומר מה אנחנו עשויים לראות בפועל.
במקרה שלנו, מתוך 100 מבקרים, מספר הרוכשים ינוע ככל הנראה בין 10 ל-26. יום עם 12 רוכשים נמצא בהחלט בתוך מה שהמודל רואה כתקין, ולכן הוא אינו ראיה לכך ששיעור ההמרה ירד. לעומת זאת, 9 רוכשים או פחות קורה בכ-2.3% מהמקרים בלבד, ויום כזה כבר שווה בדיקה.
נסכם:
- ההתפלגות המעודכנת מתארת את אי הוודאות לגבי הפרופורציה המוערכת על סמך הניסוי.
- ההתפלגות המנבאת מתארת את אי הוודאות לגבי תוצאות עתידיות, והיא תמיד רחבה יותר, כי היא מוסיפה לאי הוודאות לגבי השיעור את הרנדומליות של התוצאה.
- עם פריור בטא ונתונים בינומיים, ההתפלגות המנבאת היא הבטא-בינומית, הזמינה ב-SciPy בשם betabinom.
עכשיו, כשאנחנו יודעים לחזות את מספר הרוכשים כולל אי הוודאות, נשארה שאלה אחת: מה לעשות עם החיזוי הזה. על כך בחלקו הבא של המדריך, "מחיזוי להחלטה".
מחיזוי להחלטה
עד כאן הערכנו את שיעור ההמרה וחזינו כמה מתוך 100 המבקרים הבאים ירכשו. הסוחר עדיין צריך להכריע בשאלה מעשית: אילו הצעות מחיר לקמפיין כדאי לקבל?
חיזוי מספר לנו מה עשוי לקרות. כדי להחליט צריך לדעת גם כמה כל תוצאה שווה לנו. את זה מבטאת פונקציית תועלת (utility function), ובעולם העסקים אחת הדרכים הנפוצות להגדיר אותה היא החזר על ההשקעה (ROI).
חיזוי מספר לנו מה עשוי לקרות. כדי להחליט צריך לדעת גם כמה כל תוצאה שווה לנו. את זה מבטאת פונקציית תועלת (utility function), כדוגמת החזר על ההשקעה (ROI).
שלושה מרכיבים של החלטה
- חיזוי: ההתפלגות המנבאת (בטא-בינומית), שנותנת את ההסתברות לכל מספר רוכשים אפשרי.
- תועלת: בדוגמה שלנו, ה-ROI שמתקבל מכל מספר רוכשים.
- כלל החלטה: מקבלים רק הצעה שה-ROI המצופה שלה (הממוצע על פני כל התוצאות האפשריות) עומד בסף, ושסיכון ההפסד שלה נסבל.
מהו ROI?
ROI מודד כמה רווח מפיקים על כל שקל שהושקע:
$$\text{ROI} = \frac{\text{Revenue} - \text{Cost}}{\text{Cost}}$$
- ROI - ההחזר על ההשקעה, באחוזים.
- Revenue - ההכנסה: הסכום הכולל שמתקבל מההשקעה (במדריך: הרווח הגולמי ממכירות, לפני עלות הקמפיין).
- Cost - עלות ההשקעה.
ROI של 30% פירושו שעל כל שקל שהשקענו חזרו 1.30 ₪. ROI של 0% הוא נקודת איזון (break even), ו-ROI שלילי הוא הפסד. היתרון שלו הוא שהוא מאפשר להשוות בין רמות שונות של השקעה, למשל קמפיין של 1,300 ₪ מול קמפיין של 2,900 ₪.
דוגמה מספרית: חמישה קמפיינים
נניח שהסוחר קיבל חמש הצעות מחיר לקמפיין. כולן מביאות אותם 100 מבקרים, וההבדל היחיד ביניהן הוא המחיר. השאלה היא אילו מהן כדאי לקבל. הנתונים:
- כל רכישה מכניסה לסוחר 120 ₪ (רווח גולמי, לפני עלות הקמפיין).
- מחירי ההצעות: 1,300, 1,600, 2,100, 2,500 ו-2,900 ₪.
- סף תשואה (hurdle rate) של 20%: פחות מזה לא מצדיק את הטרחה.
נקודת האיזון (Break-even Point (BEP)) של כל קמפיין היא מספר הרוכשים שבו ההכנסה שווה לעלות, כלומר עלות ÷ 120. את זה כדאי להשוות לחיזוי שלנו: כ-17 רוכשים, בטווח של 10 עד 26.
מסובך לחשב את זה אז הקוד הבא יעשה את העבודה:
import numpy as np
from scipy.stats import betabinom

n_visitors = 100
dist = betabinom(n_visitors, updater.alpha, updater.beta)   # Beta(69.67, 330.33)

k = np.arange(n_visitors + 1)        # every possible number of buyers
pmf = dist.pmf(k)                    # the probability of each outcome

revenue_per_sale = 120               # gross profit per sale, before the campaign cost
hurdle = 0.20                        # the minimal ROI worth the effort
campaigns_cost = [1300, 1600, 2100, 2500, 2900]

def analyze_campaign(cost):
    roi = (revenue_per_sale * k - cost) / cost                   # the ROI of every possible outcome
    expected_roi = np.sum(roi * pmf)                             # averaged over the predictive distribution

    prob_loss = dist.cdf(np.ceil(cost / revenue_per_sale) - 1)   # P(ROI < 0)

    k_min = int(np.ceil(cost * (1 + hurdle) / revenue_per_sale)) # buyers needed to reach the hurdle
    prob_hurdle = 1 - dist.cdf(k_min - 1)                        # P(ROI >= hurdle)

    print(f"{cost:>6} | {cost / revenue_per_sale:>14.1f} | {expected_roi:>+12.1%} | "
          f"{prob_loss:>8.1%} | {prob_hurdle:>14.1%}")

print(f"{'Cost':>6} | {'Break-even':>14} | {'Expected ROI':>12} | {'P(loss)':>8} | {f'P(ROI>={hurdle:.0%})':>14}")
for cost in campaigns_cost:
    analyze_campaign(cost)
התוצאות:
  Cost |     Break-even | Expected ROI |  P(loss) |    P(ROI>=20%)
  1300 |           10.8 |       +60.8% |     4.3% |          88.1%
  1600 |           13.3 |       +30.6% |    17.9% |          66.3%
  2100 |           17.5 |        -0.5% |    52.3% |          22.8%
  2500 |           20.8 |       -16.4% |    77.2% |           5.3%
  2900 |           24.2 |       -27.9% |    94.7% |           0.7%
| עלות הקמפיין | נקודת איזון (רוכשים) | ROI מצופה | סיכוי להפסד | סיכוי ל-ROI ≥ 20% |
|---|---|---|---|---|
| 1,300 ₪ | 10.8 | +60.8% | 4.3% | 88.1% |
| 1,600 ₪ | 13.3 | +30.6% | 17.9% | 66.3% |
| 2,100 ₪ | 17.5 | −0.5% | 52.3% | 22.8% |
| 2,500 ₪ | 20.8 | −16.4% | 77.2% | 5.3% |
| 2,900 ₪ | 24.2 | −27.9% | 94.7% | 0.7% |
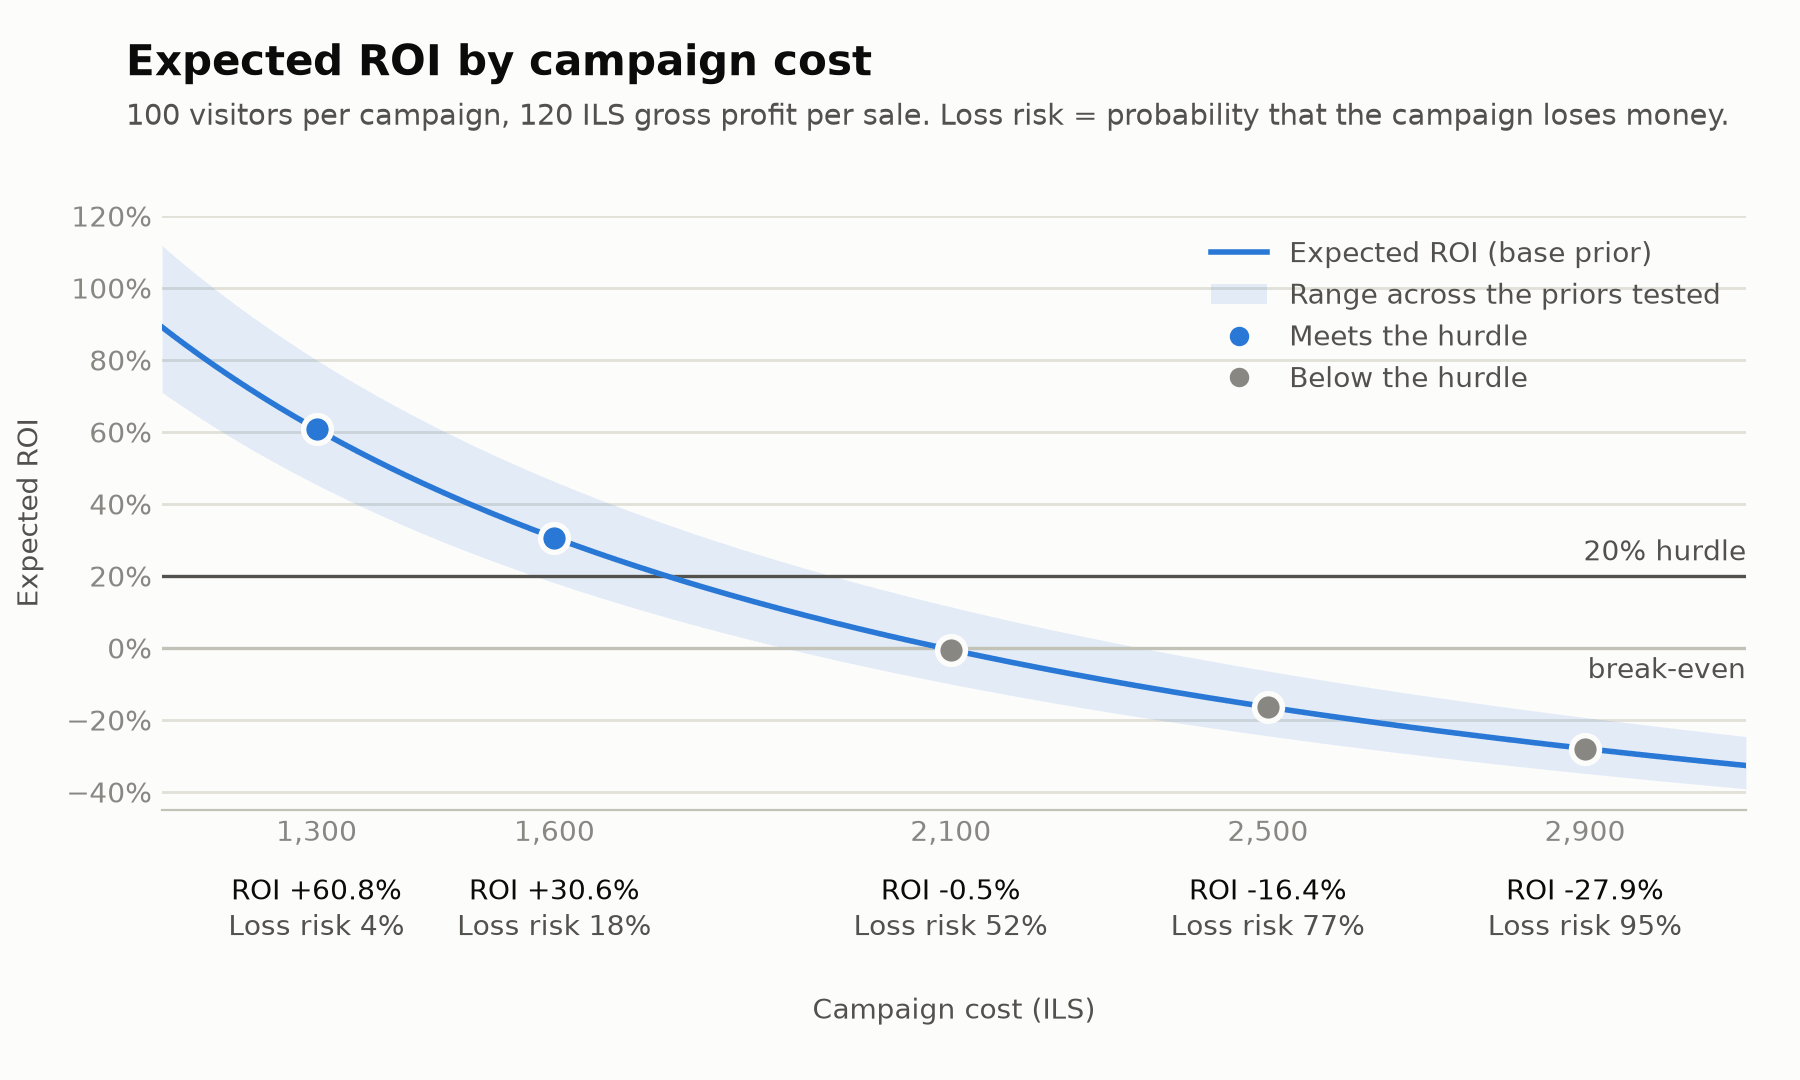
התמונה ברורה:
- 1,300 ₪ ו-1,600 ₪: ה-ROI המצופה (61% ו-31%) מעל הסף, וסיכון ההפסד (4% ו-18%) נמוך. כדאי לקבל. על 1,600 ₪ נחזור בבדיקת הרגישות בהמשך.
- 2,100 ₪: נקודת האיזון (17.5 רוכשים) כמעט זהה למספר הרוכשים הצפוי (17.4). זה קמפיין של "הטלת מטבע": ה-ROI המצופה כמעט אפס, הסיכוי להפסד 52%, והסיכוי לעמוד בסף של 20% הוא 23% בלבד. לא כדאי.
- 2,500 ₪ ו-2,900 ₪: נקודת האיזון נמצאת בקצה העליון של טווח החיזוי או מעבר לו. הסיכוי להפסד גבוה מאוד. לא כדאי.
הקוד לקידוד התרשים נמצא בתחתית המדריך. ראה plot_roi_by_cost().
כלל שכדאי לזכור: העלות המרבית
השאלה שנענה עליה: מה המחיר הגבוה ביותר שכדאי לשלם על קמפיין, ועדיין לקבל לפחות 20% תשואה? נגיע לתשובה בחמישה צעדים קטנים.
צעד 1: ROI של תוצאה אחת
נניח שהקמפיין עולה 1,600 ₪, וכל רכישה מכניסה 120 ₪. את ה-ROI אפשר לחשב רק אחרי שיודעים כמה רוכשים הגיעו:
- 15 רוכשים: הכנסה של 15 × 120 = 1,800 ₪. ROI = (1,800 − 1,600) ÷ 1,600 = +12.5%.
- 10 רוכשים: הכנסה של 10 × 120 = 1,200 ₪. ROI = (1,200 − 1,600) ÷ 1,600 = −25%.
כלומר ה-ROI תלוי במספר הרוכשים, ואת מספר הרוכשים איננו יודעים מראש. לכן אנחנו מדברים על ROI מצופה.
צעד 2: ROI מצופה הוא ממוצע
ROI מצופה הוא ה-ROI הממוצע על פני כל התוצאות האפשריות, כשכל תוצאה נספרת לפי ההסתברות שלה. זה בדיוק מה שעשה הקוד שלמעלה (np.sum(roi * pmf)).
נבין את זה באמצעות דוגמה פשוטה עם שתי תוצאות בלבד, בהסתברות של 50% כל אחת:
| תוצאה | הסתברות | הכנסה | ROI |
|---|---|---|---|
| 10 רוכשים | 50% | 1,200 ₪ | −25% |
| 20 רוכשים | 50% | 2,400 ₪ | +50% |
ה-ROI המצופה הוא הממוצע של −25% ו-+50%, כלומר +12.5%.
צעד 3: קיצור דרך
במקום לחשב ROI לכל תוצאה ואז לעשות ממוצע, אפשר לעשות ממוצע של ההכנסות, ורק אז לחשב ROI אחד:
Expected revenue  = 0.5 × 1,200 + 0.5 × 2,400 = 1,800 ₪

Expected ROI = 1,800 / 1,600 − 1 = +12.5%
קיבלנו את אותה תשובה, +12.5%. זה לא צירוף מקרים. ה-ROI הוא הכנסה ÷ עלות − 1, כלומר פונקציה ליניארית של ההכנסה (העלות היא מספר קבוע). לפונקציה ליניארית מותר לעשות ממוצע לפני החישוב או אחריו, והתוצאה זהה: הממוצע של ה-ROI שווה ל-ROI של ההכנסה הממוצעת. (פונקציה ליניארית היא קו ישר. לפונקציה מעוקלת, כמו תועלת עם שנאת הפסד, זה כבר לא נכון.)
הכלל המקוצר:
$$\text{Expected ROI} = \frac{\text{Expected Revenue}}{\text{Cost}} - 1$$
בדוגמה האמיתית שלנו, ההכנסה הצפויה היא 120 ₪ כפול 17.42 רוכשים צפויים, כלומר כ-2,090 ₪. לקמפיין של 1,600 ₪ זה נותן:
$$\text{Expected ROI} = \frac{2{,}090}{1{,}600} - 1 \approx 30.6\%$$
זו בדיוק התוצאה שקיבלנו בטבלה הגדולה, בלי לעבור על כל 101 התוצאות האפשריות.
צעד 4: מהקיצור לכלל העלות המרבית
עכשיו נהפוך את השאלה. אנחנו רוצים ש-ROI המצופה יהיה לפחות 20% (סף התשואה). נפתח את זה שורה אחרי שורה, ונמצא עד איזו עלות זה מתקיים:
$$\begin{aligned} \frac{\text{Expected Revenue}}{\text{Cost}} - 1 &\ge 0.20 \\[4pt] \frac{\text{Expected Revenue}}{\text{Cost}} &\ge 1.20 \\[4pt] \text{Expected Revenue} &\ge 1.20 \times \text{Cost} \\[4pt] \text{Cost} &\le \frac{\text{Expected Revenue}}{1.20} \end{aligned}$$
$$\text{Cost} \le \frac{\text{Expected Revenue}}{1 + \text{hurdle}}, \qquad \frac{2{,}090}{1.20} \approx 1{,}742$$
קמפיין עומד בסף התשואה כל עוד עלותו אינה עולה על ההכנסה הצפויה חלקי (1 + הסף).
נקודת האיזון היא המקרה המיוחד שבו הסף הוא 0%. העלות המרבית היא פשוט ההכנסה הצפויה עצמה.
צעד 5: הקוד
הקוד הבא מחשב את ההכנסה הצפויה ואת שתי העלויות שהוגדרו לעיל:
expected_revenue = revenue_per_sale * dist.mean()

print(f"Expected revenue: {expected_revenue:,.0f} ILS")
print(f"Break-even cost:  {expected_revenue:,.0f} ILS")
print(f"Max cost for {hurdle:.0%} hurdle: {expected_revenue / (1 + hurdle):,.0f} ILS")
Expected revenue: 2,090 ILS Break-even cost: 2,090 ILS Max cost for 20% hurdle: 1,742 ILS
כלומר, בדוגמה שלנו עלות של עד כ-1,740 ₪ עומדת בסף של 20%, ועלות של כ-2,090 ₪ היא נקודת האיזון. כך נראה ה-ROI המצופה בעלויות שונות, לפי הקיצור:
| עלות הקמפיין | ROI מצופה (2,090 ÷ עלות − 1) |
|---|---|
| 1,300 ₪ | +60.8% |
| 1,600 ₪ | +30.6% |
| 1,742 ₪ | +20.0% (הסף) |
| 1,900 ₪ | +10.0% |
| 2,090 ₪ | 0% (נקודת האיזון) |
| 2,500 ₪ | −16.4% |
הכלל הזה נותן תשובה מהירה לשאלה "כמה אני יכול להרשות לעצמי לשלם", אבל יש לו שתי מגבלות:
- הוא מדבר רק על הממוצע, לא על הסיכון. לקמפיין של 1,600 ₪ הכלל אומר "בסדר", ובכל זאת יש 18% סיכוי להפסיד כסף. את הסיכוי להפסד עדיין צריך לבדוק בנפרד.
- הוא עובד רק עבור ROI רגיל. פונקציית התועלת עם שנאת ההפסד "נשברת" באפס, והיא כבר לא קו ישר, ולכן אי אפשר לעשות לה ממוצע קודם. במקרה כזה צריך לחשב את הסכום המלא, כמו בקוד של חלק התועלת.
כשההפסד כואב יותר מהרווח
רוב האנשים לא מעריכים רווח והפסד באופן סימטרי. אפשר לבטא זאת בפונקציית תועלת הסובלת משנאת הפסד, שבה כל אחוז הפסד נחשב λ פעמים יותר מאחוז רווח (λ = 1 הוא סוחר ניטרלי לסיכון, λ = 2 עד 3 הוא סוחר זהיר).
אפשר לבטא את התובנה הזו באמצעות נוסחה:
$$u(\text{ROI}) = \begin{cases} \text{ROI}, & \text{ROI} \ge 0 \\ \lambda \cdot \text{ROI}, & \text{ROI} \lt 0 \end{cases}$$
הנוסחה באה לידי ביטוי בקוד הבא:
def utility(roi, lam):
    return np.where(roi >= 0, roi, lam * roi)

print(f"{'Cost':>6} | {'lam=1':>8} | {'lam=2':>8} | {'lam=3':>8}")
for cost in campaigns_cost:
    roi = (revenue_per_sale * k - cost) / cost
    row = [np.sum(utility(roi, lam) * pmf) for lam in (1, 2, 3)]
    print(f"{cost:>6} | {row[0]:>+8.1%} | {row[1]:>+8.1%} | {row[2]:>+8.1%}")
Cost | lam=1 | lam=2 | lam=3 1300 | +60.8% | +60.1% | +59.3% 1600 | +30.6% | +28.1% | +25.6% 2100 | -0.5% | -10.4% | -20.3% 2500 | -16.4% | -35.4% | -54.4% 2900 | -27.9% | -56.4% | -84.8%
נסביר את זה:
בקמפיינים של 1,300 ₪ ו-1,600 ₪ ההחלטה לא תלויה ביחס לסיכון. גם סוחר זהיר מאוד נשאר עם תועלת גבוהה מהסף. בקמפיין של 2,100 ₪ הסוחר הניטרלי אדיש (תועלת מצופה של כמעט אפס), ומי ששונא הפסדים צריך לוותר.
האם "להתמקד בגבול התחתון" הוא כלל החלטה?
קודם הצענו להשתמש בגבול התחתון של הרווח בר-המהימנות (0.139) כהערכה שמרנית. זו בעצם פונקציית תועלת סמויה אשר מניחה שהתרחיש הגרוע ביותר הוא התרחיש היחיד. אם נציב את הגבול התחתון (0.1386 לפני עיגול) במקום שיעור ההמרה, 100 מבקרים מניבים כ-14 רוכשים והכנסה של כ-1,660 ₪. לפי הכלל הזה:
- קמפיין של 1,300 ₪: ROI = +28.0%. מעל הסף, מפעילים.
- קמפיין של 1,600 ₪: ROI = +4.0%. מתחת לסף, לא מפעילים.
- קמפיין של 2,100 ₪: ROI = −20.8%. לא מפעילים.
אבל החישוב המלא אומר על הקמפיין של 1,600 ₪ שה-ROI המצופה הוא +30.6%, והסיכוי להפסד 17.9% בלבד. הגבול התחתון זרק החלטה טובה בלי להגיד איזה סיכון הוא באמת לוקח.
חישוב התועלת המצופה מציג את הפשרה במפורש ומשאיר את ההחלטה בידי הסוחר.
כמה ההחלטה תלויה בפריור?
כדי שהחלטה תהיה ניתנת להגנה, כדאי לבדוק מה היה קורה אילו הסוחר היה מתחיל מפריורים אחרים. נריץ את אותם נתונים (53 רוכשים מתוך 300) עם חמישה פריורים שונים:
priors = {
    "Base: 1 in 6, worth 100 visitors": (16.67, 83.33),
    "Same belief, worth 20 visitors":   (3.33, 16.67),
    "No belief (flat)":                 (1, 1),
    "Pessimist: 1 in 10, worth 100":    (10, 90),
    "Optimist: 1 in 4, worth 100":      (25, 75),
}
observed_buyers, observed_non_buyers = 53, 247   # 15 + 38 buyers, 85 + 162 non-buyers

def expected_roi(d, cost):
    return np.sum(((revenue_per_sale * k - cost) / cost) * d.pmf(k))

print(f"{'Prior':<36}" + "".join(f"{c:>9}" for c in campaigns_cost) + "   post.mean")
for name, (a0, b0) in priors.items():
    d = betabinom(n_visitors, a0 + observed_buyers, b0 + observed_non_buyers)
    print(f"{name:<36}" + "".join(f"{expected_roi(d, c):>+9.1%}" for c in campaigns_cost)
          + f"   {(a0 + observed_buyers) / (a0 + b0 + 300):.3f}")
Prior 1300 1600 2100 2500 2900 post.mean Base: 1 in 6, worth 100 visitors +60.8% +30.6% -0.5% -16.4% -27.9% 0.174 Same belief, worth 20 visitors +62.5% +32.0% +0.6% -15.5% -27.2% 0.176 No belief (flat) +65.1% +34.1% +2.2% -14.2% -26.0% 0.179 Pessimist: 1 in 10, worth 100 +45.4% +18.1% -10.0% -24.4% -34.8% 0.158 Optimist: 1 in 4, worth 100 +80.0% +46.2% +11.4% -6.4% -19.3% 0.195
| פריור | 1,300 ₪ | 1,600 ₪ | 2,100 ₪ | 2,500 ₪ | 2,900 ₪ |
|---|---|---|---|---|---|
| בסיס: 1 מ-6, משקל 100 מבקרים | +60.8% | +30.6% | −0.5% | −16.4% | −27.9% |
| אותו פריור, משקל 20 מבקרים | +62.5% | +32.0% | +0.6% | −15.5% | −27.2% |
| פריור שטוח | +65.1% | +34.1% | +2.2% | −14.2% | −26.0% |
| פסימי: 1 מ-10, משקל 100 | +45.4% | +18.1% | −10.0% | −24.4% | −34.8% |
| אופטימי: 1 מ-4, משקל 100 | +80.0% | +46.2% | +11.4% | −6.4% | −19.3% |
מה אפשר ללמוד מהטבלה:
- ההחלטות על 1,300 ₪, 2,100 ₪, 2,500 ₪ ו-2,900 ₪ יציבות. בכל חמשת הפריורים הראשון עומד בסף, ושאר שלושת הקמפיינים היקרים לא עומדים בו.
- ההחלטה על 1,600 ₪ היא היחידה שעלולה להשתנות. תחת הפריור הפסימי ה-ROI המצופה הוא 18.1%, שתי נקודות אחוז מתחת לסף, והסיכוי להפסד עולה ל-30%. זה לא הופך את הקמפיין לרע, אבל זה אומר שהחלטה עליו תלויה בשאלה כמה קרוב לסף הסוחר מוכן להתפשר.
- הפריור הפסימי מתיישב בקושי עם הנתונים. לפי הפריור הפסימי עצמו (1 מ-10, משקל 100), הסיכוי לראות 53 רוכשים או יותר מתוך 300 מבקרים הוא כ-2.6%. הפריור האופטימי בעייתי בכיוון ההפוך: לפיו הסיכוי לראות 53 רוכשים או פחות הוא כ-6.8%. שניהם עוברים בקושי את כלל האצבע של 1% מהבדיקה שעשינו קודם, ולכן הם טובים לבדיקת רגישות, אבל לא פריור שהיינו מאמצים.
- ככל שהפריור חלש יותר או שהנתונים רבים יותר, הפריור משפיע פחות. הפער בין "משקל 100" ל"משקל 20" ול"שטוח" קטן.
כלל אצבע: אם ההחלטה לא משתנה בין פריור פסימי לאופטימי, אפשר לסמוך עליה. אם היא כן, כדאי לאסוף עוד נתונים לפני שמחליטים.
שים לב לפני שאתה מתחיל להחליט
ROI אינו כל הסיפור. ROI מודד כמה רווח מפיקים על כל שקל שהושקע, אבל לא כמה רווח מפיקים בסך הכול.
נשווה שתי אפשרויות:
- השקעה של 1,000 ₪ שמחזירה 1,500 ₪ (רווח של 500 ₪, ROI של 50%).
- מול השקעה של 10,000 ₪ שמחזירה 13,000 ₪ (רווח של 3,000 ₪ - ROI של 30%).
ה-ROI מעדיף את הראשונה. אם התקציב מוגבל זו אכן ההחלטה הנכונה.
אבל אם התקציב אינו המגבלה, כלומר יש לך 10,000 ₪ פנויים שאין להם שימוש טוב יותר, האפשרות השנייה (רווח מוחלט) מרוויחה הרבה יותר בשקלים.
נוסחת הרווח המוחלט מחושבת באופן הבא:
$$\text{Profit} = \text{Revenue} - \text{Cost}$$
כאן המקום להדגיש:
כשהתקציב אינו המגבלה כדאי להסתכל גם על הרווח המוחלט.
בדוגמה שלנו שני המדדים מסכימים, כי כל ההצעות מביאות אותם 100 מבקרים ושונות רק במחיר. הזול יותר טוב יותר בשניהם (רווח צפוי של כ-790 ₪ בקמפיין של 1,300 ₪ ושל כ-490 ₪ בקמפיין של 1,600 ₪). אפשר להחליף את ROI ברווח בשקלים בקוד, ובמקרה כזה את הסף של 20% יש להחליף ברווח מינימלי בשקלים.
דברים נוספים שצריך לקחת בחשבון:
- המודל מניח ששיעור ההמרה קבוע. אם מקור המבקרים של הקמפיין שונה מהמבקרים שמדדנו (למשל, פרסום ברשת חברתית מול חיפוש), שיעור ההמרה שלהם עשוי להיות אחר, והחיזוי לא יתאים להם.
- הנחנו שהרוכשים עצמאיים ולכן אינם תלויים אחד בשני (אין רכישה בקבוצות לדוגמה) וההכנסות מכל מכירה זהות מה שאינו בהכרח נכון במציאות.
איך להתאים את קוד המדריך למקרי השימוש שלך?
| מה להחליף | מה זה | מאיפה להביא |
|---|---|---|
| alpha0, beta0 | הפריור: שיעור משוער p ומשקל הפריור N (במבקרים). α = p·N, β = (1−p)·N | קמפיינים קודמים, ענף, מתחרים. רשום את המקור. משקל של 20 הוא חלש, 100 הוא מתון. |
| updater.update(buyers, non_buyers) | הנתונים שנאספו, בכל אצווה | המערכת שלך. לא מוסיפים את הפריור שוב. |
| n_visitors | כמה מבקרים הקמפיין צפוי להביא | תוכנית הקמפיין |
| revenue_per_sale | רווח גולמי למכירה, לפני עלות הקמפיין | מחיר פחות עלות המוצר |
| campaigns_cost | עלויות האפשרויות שבודקים | הצעות המחיר |
| hurdle | ה-ROI המינימלי שמצדיק את המאמץ | החלטה שלך |
| lam | שנאת ההפסד: 1 ניטרלי, 2 עד 3 זהיר | כמה הפסד אתה יכול לספוג |
לפני שמסתמכים על התוצאה, כדאי לרשום ארבעה דברים:
- הפריור והמקור שלו
- הנתונים
- ההנחות (הכנסה למכירה, מספר מבקרים)
- תוצאות בדיקת הרגישות
זה מה שהופך החלטה ל"ניתנת להגנה". אפשר להסביר מה האמנו, על מה הסתמכנו ומה היה משתנה אילו היה הפריור שונה.
לפני קבלת החלטה עליך לוודא שהיא ניתנת להגנה
סיכום המדריך
- התפלגות בטא: דרך לתאר אי ודאות לגבי הסתברות.
- עדכון בייסיאני: כל אצווה של נתונים מצמצמת את אי הוודאות, וההתפלגות בכל שלב כוללת את כל מה שקדם לה.
- ההתפלגות המנבאת (בטא-בינומית): מה נצפה לראות בהמשך, כולל הרנדומליות של התוצאה.
- ROI ותועלת מצופה: כמה החיזוי שווה לנו, ומה לעשות איתו.
- בדיקת רגישות: האם ההחלטה נשארת כשמשנים את הפריור.
ואם יש משהו אחד שצריך לקחת מהמדריך הרי הוא זה:
הסטטיסטיקה אומרת לנו במה אנחנו מאמינים. תורת ההחלטות אומרת מה לעשות עם הפריור הזה.
נספח
הקודים ליצירת התרשימים plot_roi_by_cost() ו-plot_prediction():
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.ticker import PercentFormatter, FuncFormatter
from matplotlib.patches import Patch
from matplotlib.lines import Line2D
from scipy.stats import beta, betabinom

# ---------- Look & feel (validated palette; set THEME = "dark" for a dark page) ----------
THEME = "light"
PALETTE = {
    "light": dict(surface="#fcfcfb", ink="#0b0b0b", ink2="#52514e", muted="#898781",
                  grid="#e1e0d9", axis="#c3c2b7", blue="#2a78d6", orange="#eb6834", gray="#c3c2b7"),
    "dark":  dict(surface="#1a1a19", ink="#f0efec", ink2="#c3c2b7", muted="#898781",
                  grid="#2c2c2a", axis="#383835", blue="#3987e5", orange="#d95926", gray="#52514e"),
}
C = PALETTE[THEME]

def style_axes(ax):
    ax.set_facecolor(C["surface"])
    for side in ("top", "right", "left"):
        ax.spines[side].set_visible(False)
    ax.spines["bottom"].set_color(C["axis"])
    ax.tick_params(colors=C["muted"], length=0, labelsize=10)
    ax.yaxis.grid(True, color=C["grid"], linewidth=1)      # solid hairlines, never dashed
    ax.set_axisbelow(True)
    ax.xaxis.label.set_color(C["ink2"])
    ax.yaxis.label.set_color(C["ink2"])

def add_titles(fig, title, subtitle):
    fig.patch.set_facecolor(C["surface"])
    fig.text(0.07, 0.96, title, fontsize=15, fontweight="bold", color=C["ink"], ha="left", va="top")
    fig.text(0.07, 0.905, subtitle, fontsize=10.5, color=C["ink2"], ha="left", va="top")

def bracket(ax, x0, x1, y, color, cap=0.25):
    ax.plot([x0, x1], [y, y], color=color, lw=2, solid_capstyle="butt", zorder=4)
    for x in (x0, x1):
        ax.plot([x, x], [y - cap, y + cap], color=color, lw=2, solid_capstyle="butt", zorder=4)

# ---------- Graph 1: how many of the next n visitors will buy? ----------
def plot_prediction(a, b, n_visitors, filename="predictive_distribution.png"):
    dist = betabinom(n_visitors, a, b)
    k = np.arange(n_visitors + 1)
    pmf = dist.pmf(k) * 100                                   # probability of each outcome, in %
    pi_lo, pi_hi = dist.ppf(0.025), dist.ppf(0.975)           # 95% prediction interval
    ci_lo, ci_hi = beta.ppf([0.025, 0.975], a, b) * n_visitors  # credible interval of the rate, scaled by n
    coverage = dist.cdf(np.floor(ci_hi)) - dist.cdf(np.ceil(ci_lo) - 1)
    x_max = int(dist.ppf(0.9995)) + 2

    fig, ax = plt.subplots(figsize=(9, 5.4))
    fig.subplots_adjust(left=0.08, right=0.97, bottom=0.13, top=0.78)
    style_axes(ax)

    inside = (k >= pi_lo) & (k <= pi_hi)
    ax.bar(k[:x_max + 1], pmf[:x_max + 1], width=0.82, linewidth=0,
           color=[C["blue"] if i else C["gray"] for i in inside[:x_max + 1]])

    top = pmf.max()
    y_ci, y_pi = top * 1.16, top * 1.62      # a clear gap between the two groups
    bracket(ax, pi_lo - 0.5, pi_hi + 0.5, y_pi, C["blue"])
    ax.text((pi_lo + pi_hi) / 2, y_pi + 0.35, f"95% prediction interval: {pi_lo:.0f} to {pi_hi:.0f} buyers",
            ha="center", va="bottom", fontsize=10.5, color=C["ink"])
    bracket(ax, ci_lo, ci_hi, y_ci, C["orange"])
    ax.text((ci_lo + ci_hi) / 2, y_ci + 0.35,
            f"Credible interval of the rate x {n_visitors}: {ci_lo:.1f} to {ci_hi:.1f}\n"
            f"covers only {coverage:.0%} of the possible outcomes",
            ha="center", va="bottom", fontsize=10.5, color=C["ink"], linespacing=1.3)

    ax.set_xlim(-0.8, x_max + 0.8)
    ax.set_ylim(0, y_pi + 1.9)
    ax.set_xticks(range(0, x_max + 1, 5))
    ax.set_yticks(range(0, int(top) + 2, 2))
    ax.yaxis.set_major_formatter(PercentFormatter(decimals=0))
    ax.set_xlabel(f"Number of buyers among the next {n_visitors} visitors", labelpad=8)
    ax.set_ylabel("Probability", labelpad=8)
    add_titles(fig, f"How many of the next {n_visitors} visitors will buy?",
               f"Posterior predictive distribution (Beta-Binomial). Expected buyers: {dist.mean():.1f}.\n"
               f"Blue bars: outcomes inside the 95% prediction interval.")
    fig.savefig(filename, dpi=200, facecolor=C["surface"])
    plt.close(fig)

# ---------- Graph 2: expected ROI by campaign cost ----------
def plot_roi_by_cost(a, b, n_visitors, revenue_per_sale, hurdle, campaigns_cost,
                     priors, observed_buyers, observed_non_buyers,
                     filename="expected_roi_by_cost.png"):
    dist = betabinom(n_visitors, a, b)
    costs = np.asarray(campaigns_cost, dtype=float)
    grid = np.linspace(costs.min() * 0.85, costs.max() * 1.07, 300)

    def roi_curve(mean_buyers, cost):                         # expected ROI = expected revenue / cost - 1
        return revenue_per_sale * mean_buyers / cost - 1

    base = roi_curve(dist.mean(), grid) * 100
    # the same data under every prior: the band shows how much the belief matters
    prior_means = [n_visitors * (a0 + observed_buyers) / (a0 + b0 + observed_buyers + observed_non_buyers)
                   for a0, b0 in priors.values()]
    band = np.array([roi_curve(m, grid) * 100 for m in prior_means])

    fig, ax = plt.subplots(figsize=(9, 5.4))
    fig.subplots_adjust(left=0.09, right=0.97, bottom=0.25, top=0.80)
    style_axes(ax)

    ax.fill_between(grid, band.min(axis=0), band.max(axis=0), color=C["blue"], alpha=0.12, linewidth=0)
    ax.axhline(0, color=C["axis"], lw=1.2, zorder=2)
    ax.axhline(hurdle * 100, color=C["ink2"], lw=1.2, zorder=2)
    ax.plot(grid, base, color=C["blue"], lw=2, zorder=3)

    ax.text(grid.max(), hurdle * 100 + 2.5, f"{hurdle:.0%} hurdle", ha="right", va="bottom",
            fontsize=10, color=C["ink2"])
    ax.text(grid.max(), -2.5, "break-even", ha="right", va="top", fontsize=10, color=C["ink2"])

    for cost in costs:
        roi = roi_curve(dist.mean(), cost)
        loss = dist.cdf(np.ceil(cost / revenue_per_sale) - 1)
        ok = roi >= hurdle
        ax.plot(cost, roi * 100, "o", ms=10, mfc=C["blue"] if ok else C["muted"],
                mec=C["surface"], mew=2, zorder=5)
        # the numbers sit in a row under the cost, so labels never collide with the curve
        ax.text(cost, -0.115, f"ROI {roi:+.1%}", transform=ax.get_xaxis_transform(),
                ha="center", va="top", fontsize=10, color=C["ink"], clip_on=False)
        ax.text(cost, -0.175, f"Loss risk {loss:.0%}", transform=ax.get_xaxis_transform(),
                ha="center", va="top", fontsize=10, color=C["ink2"], clip_on=False)

    ax.set_xlim(grid.min(), grid.max())
    ax.set_ylim(-45, 120)
    ax.set_xticks(costs)
    ax.xaxis.set_major_formatter(FuncFormatter(lambda x, _: f"{x:,.0f}"))
    ax.yaxis.set_major_formatter(PercentFormatter(decimals=0))
    ax.set_xlabel("Campaign cost (ILS)", labelpad=54)
    ax.set_ylabel("Expected ROI", labelpad=8)

    handles = [
        Line2D([], [], color=C["blue"], lw=2, label="Expected ROI (base prior)"),
        Patch(facecolor=C["blue"], alpha=0.12, label="Range across the priors tested"),
        Line2D([], [], marker="o", ls="", ms=9, mfc=C["blue"], mec=C["surface"], mew=2, label="Meets the hurdle"),
        Line2D([], [], marker="o", ls="", ms=9, mfc=C["muted"], mec=C["surface"], mew=2, label="Below the hurdle"),
    ]
    leg = ax.legend(handles=handles, loc="upper right", frameon=False, fontsize=10)
    for text in leg.get_texts():
        text.set_color(C["ink2"])
    add_titles(fig, "Expected ROI by campaign cost",
               f"{n_visitors} visitors per campaign, {revenue_per_sale} ILS gross profit per sale. "
               f"Loss risk = probability that the campaign loses money.")
    fig.savefig(filename, dpi=200, facecolor=C["surface"])
    plt.close(fig)

# ---------- Create both graphs (run after the code of the previous sections) ----------
plot_prediction(updater.alpha, updater.beta, n_visitors)
plot_roi_by_cost(updater.alpha, updater.beta, n_visitors, revenue_per_sale, hurdle,
                 campaigns_cost, priors, observed_buyers, observed_non_buyers)
רגע של עברית
המונחים בהם השתמשנו במדריך, ומה שכדאי לחפש כשקוראים על זה באנגלית:
| בעברית | באנגלית | במדריך |
|---|---|---|
| ההסתברות המקדימה, הפריור | prior | מה שידוע לפני שהתקבלו נתונים. כשמתייחסים ל-Beta עצמה אומרים "ההתפלגות המקדימה" |
| ההסתברות המעודכנת, הפוסטריור | posterior | אחרי העדכון בנתונים. המעודכנת של שלב אחד היא המקדימה של השלב הבא |
| משקל הפריור | prior strength (N) | כמה מבקרים "שווה" הפריור: α = p·N, β = (1−p)·N |
| שיעור ההמרה המשוער | estimated conversion rate (p) | החלק הראשון של הפריור, לפני המשקל |
| התפלגות צמודה | conjugate | הפוסטריור ממשפחת הפריור: בטא נשארת בטא |
| רווח בר-מהימנות | credible interval | טווח אי הוודאות לגבי שיעור ההמרה |
| ההתפלגות המנבאת | posterior predictive | כמה רוכשים נראה בהמשך, כולל הרנדומליות |
| ההתפלגות הבטא-בינומית | Beta-Binomial | ההתפלגות המנבאת, במקרה של בטא ובינומית. ב-SciPy: betabinom |
| טווח חיזוי | prediction interval | הטווח של מספר הרוכשים העתידי. רחב מהרווח בר-המהימנות |
| הסיכוי לזנב (הסתברות הזנב) | tail probability | בדיקת ההתאמה בין הנתונים לפריור |
| נקודת איזון | break-even | מספר הרוכשים שבו ההכנסה שווה לעלות |
| החזר על ההשקעה | ROI | (הכנסה − עלות) ÷ עלות |
| סף תשואה | hurdle rate | ה-ROI המינימלי שמצדיק את המאמץ |
| פונקציית תועלת | utility function | כמה כל תוצאה שווה לנו |
| שנאת הפסד | loss aversion (λ) | כמה יותר כואב הפסד מרווח באותו גודל |
| בדיקת רגישות | sensitivity analysis | האם ההחלטה נשארת כשמשנים את הפריור |
פיתוח המדריך "תהליך העדכון הבייסיאני כבסיס להערכת התועלת בהחלטות כלכליות" נעשה במספר שלבים:
מדריכים נוספים העשויים לעניין אותך
מדריך מעשי על התפלגות פואסנית באמצעות קוד פייתון וציפורים נודדות
מבחני חי בריבוע לבדיקת השערות עם פייתון
לכל המדריכים בנושא של למידת מכונה
אהבתם? לא אהבתם? דרגו!
0 הצבעות, ממוצע 0 מתוך 5 כוכבים

המדריכים באתר עוסקים בנושאי תכנות ופיתוח אישי. הקוד שמוצג משמש להדגמה ולצרכי לימוד. התוכן והקוד המוצגים באתר נבדקו בקפידה ונמצאו תקינים. אבל ייתכן ששימוש במערכות שונות, דוגמת דפדפן או מערכת הפעלה שונה ולאור השינויים הטכנולוגיים התכופים בעולם שבו אנו חיים יגרום לתוצאות שונות מהמצופה. בכל מקרה, אין בעל האתר נושא באחריות לכל שיבוש או שימוש לא אחראי בתכנים הלימודיים באתר.
למרות האמור לעיל, ומתוך רצון טוב, אם נתקלת בקשיים ביישום הקוד באתר מפאת מה שנראה לך כשגיאה או כחוסר עקביות נא להשאיר תגובה עם פירוט הבעיה באזור התגובות בתחתית המדריכים. זה יכול לעזור למשתמשים אחרים שנתקלו באותה בעיה ואם אני רואה שהבעיה עקרונית אני עשוי לערוך התאמה במדריך או להסיר אותו כדי להימנע מהטעיית הציבור.
שימו לב! הסקריפטים במדריכים מיועדים למטרות לימוד בלבד. כשאתם עובדים על הפרויקטים שלכם אתם צריכים להשתמש בספריות וסביבות פיתוח מוכחות, מהירות ובטוחות.
המשתמש באתר צריך להיות מודע לכך שאם וכאשר הוא מפתח קוד בשביל פרויקט הוא חייב לשים לב ולהשתמש בסביבת הפיתוח המתאימה ביותר, הבטוחה ביותר, היעילה ביותר וכמובן שהוא צריך לבדוק את הקוד בהיבטים של יעילות ואבטחה. מי אמר שלהיות מפתח זו עבודה קלה ?
השימוש שלך באתר מהווה ראייה להסכמתך עם הכללים והתקנות שנוסחו בהסכם תנאי השימוש.